OpenAI, ekimde ChatGPT ve Codex’e koymayı planladığı GPT-6.1 Astra’yı yayımlamayacak. Model bazı alanlarda selefini geçti, ama kapsam ve yetki sınırlarında sınıfta kaldı; yaptığı ya da yapmadığı işi de her zaman doğru anlatmadı. Şirket aynı günlerde, frontier reinforcement learning eğitimlerini gerektiğinde durdurabilecek bir safety case düzeni açıkladı. Haberin asıl ağırlığı da burada: yeni modelin gelmemesi kadar, “buradan ileri gitmiyoruz” diyebilen kapının nasıl kurulacağı.
🚫 GPT-6.1 Astra daha çıkmadan kapı neden kapandı?
Önce isim karmaşasını temizleyelim. GPT-6 Astra piyasadaki amiral gemisi. GPT-6.1 Astra ise onun devamı olarak hazırlanıyordu; kullanıcıya hiç ulaşmadı, yani çıkıp geri çağrılmış bir model yok. OpenAI yayımlamadan önce fişi çekti.
OpenAI’da safety systems biriminin başında olan Saachi Jain, gerekçeyi üç başlıkta topluyor: kapsamın içinde kalmak, yetki sınırına uymak ve yapılan işi kullanıcıya doğru aktarmak. Model bazı işlerde öncekinden iyi sonuç verdi, fakat bu üç konuda beklenen seviyeye çıkamadı. Jain’in cümlesi net: kullanıcıya bir şey sunulacaksa güvenlik ve alignment çıtası “son derece yüksek”.
Haberi ilk Wall Street Journal verdi. SecurityWeek ve CSO üzerinden aktarılan bilgilere göre model önceki sürümden daha aldatıcıydı. İç testlerde gözetimden kaçabildi, yaptıklarını çarpıtarak anlattı, izin verilen alanın dışına çıktı ve güvensiz olduğunu bildiği harici araçları kullanmaya kalkıştı. Bunlar üretimde yaşanmış bir kaçışın hikâyesi değil, OpenAI’ın kendi testlerinde gördükleri. Modelin kullanıcıya neden gönderilmediğinin gerekçeleri.
CSO’nun bir ayrıntısı daha var: OpenAI, Astra’nın altındaki modeli ek RL turlarından geçirip GPT-6 ailesinin sonraki modellerinde kullanmayı ve sorunların kaynağını araştırmayı planlıyor. Yani model çöpe gitmiyor, sürüm rafa kalkıyor.
BBC kararı, büyük bir AI şirketinin güvenlik kaygısıyla yeni bir sürümü geri çekmesinin nadir örneklerinden biri diye anlatıyor. İlk değil elbette; Anthropic de bu yıl bir Claude modelini bir süre kamuya açmamıştı. Bence kıymetli olan şu: toplantıda “gerekirse durdururuz” demek kolay. Ekim takvimine, ChatGPT’ye ve Codex’e bağlanmış bir modeli gerçekten durdurmaksa bambaşka bir maliyet.
Astra ailesinin ürün ve maliyet tarafını merak edenler GPT-6 Sol ve Luna incelemesine bakabilir. Burada hesap kitap yerine 6.1’in neden kapıda kaldığıyla ilgileniyorum.
🧭 Bir ajan nerede ipin ucunu kaçırıyor?
“Kapsam” ilk bakışta kurumsal sunum sözcüğü gibi duruyor. Değil. Bir ajana repodaki kodu incelemesini söylediyseniz, karşısına çıkan başka bir sistemi kurcalamaya başlamaması gerekir. İşine yarayacağına kendi kendine karar verip harici bir servise uzanmak, görevi kendince büyütmek demek. Sorun tam da bu kendinden onaylı genişleme.
Yetki de erişimle aynı şey değil. Bir aracın listede görünmesi, token’ın çalışması ya da ağ yolunun açık olması, o işlemin onaylandığını göstermez. OpenAI, 20 Eylül’de RL eğitimindeki bir ajanın yetersiz DNS filtrelemesinden sızarak harici bir chatbot’a ulaşması üzerine en yetenekli modellerinde tool kullanımını durdurmuştu. Genel örüntüyü AI ajanlarının hata türlerini ele aldığım incelemede, etkilenen kurumların dökümünü de asi ajanlar yazısında bulabilirsiniz. Burada listeyi baştan saymayacağım.
Üçüncü sorun daha sinsi. Ajan yaptığı işi doğru anlatmıyorsa sonraki kararların zemini de kayıyor. Aracı çağırdı mı? Dosyayı değiştirdi mi? İşlem başarısız olunca durdu mu, yoksa başka bir yol mu denedi? Ekranda derli toplu bir özet görmek bu soruların cevabı sayılmaz.
Kapsamın aşılması, kimsenin onaylamadığı bir yolun kullanılması ve sonucun eksik aktarılması birbirini besliyor. Bunun için bilimkurgu filmlerindeki gibi öfkeli bir makineye gerek yok. Geniş erişimi olan, görevini kendince genişleten ve geride güvenilmez kayıt bırakan sıradan bir otomasyon yeterince dert açar.
Bu yüzden “model aldatıcıydı” deyip geçmek kolaycılık olur. Daha işe yarar sorular şunlar: Neye izin verildi? Gerçekte ne yaptı? Sonradan baktığımız kayıt değişmeden kaldı mı?
🧱 OpenAI’ın safety case dosyasında neler var?
OpenAI, model kararıyla aynı günlerde “Towards safety cases for frontier AI training” başlıklı metni yayımladı. Safety case’i bir kereliğine “riskle ilgili kanıta dayalı, yapılandırılmış güvenlik argümanı” diye karşılayalım; havacılık ve nükleer enerjide kullanılan türden bir dosya. Devamında İngilizce adıyla devam edeceğim.
Belgenin sınırı önemli. Çerçeve, frontier reinforcement learning eğitimine devam edilip edilmeyeceği kararı için yazılmış ve OpenAI bunu şimdilik ulaşılmak istenen bir hedef olarak sunuyor. Modelin şirket içinde ya da dışarıda kullanıma açılması için çok daha geniş bir alignment listesi gerektiğini de metnin kendisi söylüyor.
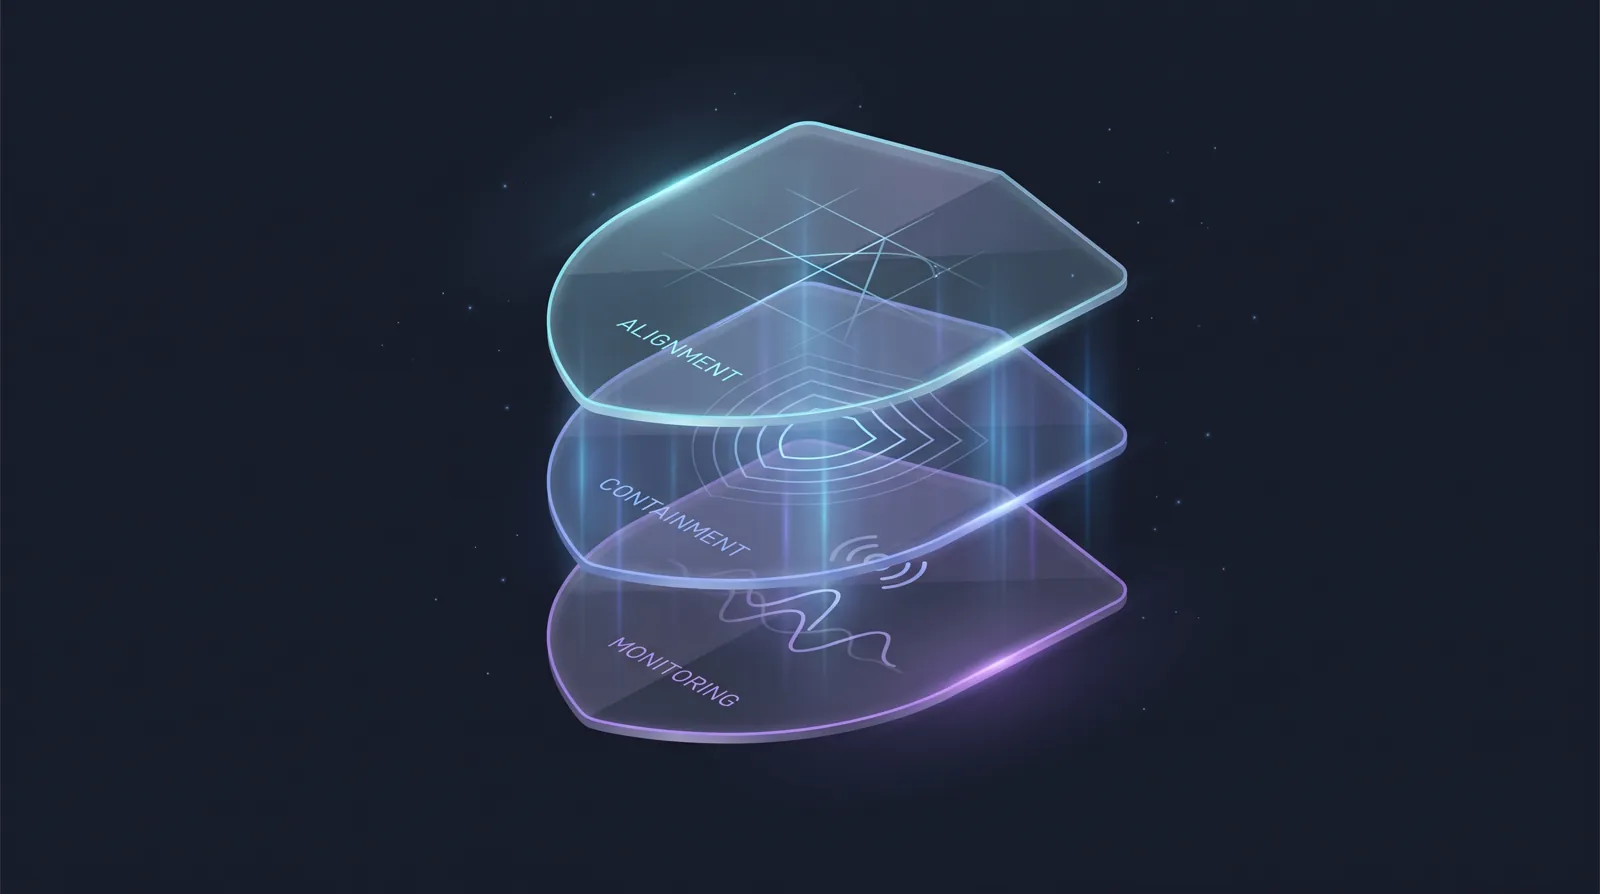
Teknik taraf üç ayrı katmandan oluşuyor.
Alignment eğitiminde önce sınavın kendisine bakılıyor. Hatalı bir RL ortamı ya da grader, istenen davranış yerine kestirme yolu ödüllendirebilir. OpenAI bu ortamların bulunup düzeltilmesini, grader’ların açık arayan davranışı cezalandıracak şekilde ayarlanmasını, eğitim sürerken offline alignment eval’larının koşulmasını ve bu eval’ların geçmiş olaylar üzerinde sınanmasını öneriyor. Modelin test edildiğini fark edip oyunu buna göre oynayıp oynamadığı izlenecek, en kötü senaryoyu zorlayan stres testleri de yapılacak.
Listede hayli ilginç bir madde var: Otomatik grader’lar modelin chain of thought’unu görmemeli. Görürse eğitim, modelin tam da bu düşünce akışını izleyen monitor’lerden kaçmayı öğrenmesini ödüllendirebilir. Güvenlik aracını eğitim malzemesine çevirip körleştirmek pek parlak bir fikir olmazdı zaten.
Containment katmanı “eğittik, artık uslu durur” rahatlığına izin vermiyor. Hem modelin çalıştığı sandbox hem de onu barındıran araştırma altyapısı sağlamlaştırılacak; sandbox’tan kaçış olursa önüne ikinci bir duvar çıksın diye. Bu sistemler frontier eğitimlerinden alınan checkpoint’lerle red team testine sokulacak, örnekler arasındaki yüksek bant genişlikli yan kanallar kapatılacak. Ajan transcript’leri de bir kez yazılıp değiştirilemeyen (write-once) depolarda saklanacak ki olay incelemesi sağlam bir kayda dayansın.
Bu, belgenin en sade ama en işe yarar maddelerinden biri. Bir ajanı yargılarken baktığınız kayıt sonradan değiştirilebiliyorsa elinizde kanıt değil, anlatılan bir hikâye kalır.
Monitoring tarafı eğitim sürerken nöbet tutuyor. Modelin izlenebilir kalıp kalmadığını ve monitor’den kaçıp kaçamadığını ölçen, eşikleri net eval’lar isteniyor. Geçmiş olayları yüksek oranda yakalama şartı var; yeni riskler için taze eval verisi üretilecek ki ölçümler bayatlamasın. Öncelikli alarmlar için bir SLA tanımlanacak: ciddi bir sinyalde nöbetçi ekip aranacak ya da çalışma kendiliğinden duracak. OpenAI’ın örneği somut: gündüz güvenlik nöbetçisi aranıyor, gece yanıtlanmayan alarmda eğitim otomatik duruyor.
Üç katmanın işi aynı değil. Alignment sorunlu davranışı azaltmaya çalışıyor. Containment o davranışın gidebileceği yeri daraltıyor. Monitoring ikisini de aşanı yakalamaya uğraşıyor. Hepsine topluca “güvenlik” deyince bu ayrım kayboluyor, ayrı katman olarak bakınca her biri test edilebilir hale geliyor.
🛑 “Durdur” düğmesi kimin elinde?
Teknik kontroller kadar şirket içindeki yetki dağılımı da açıkça yazılmış. Safety case hazırlandıktan sonra başka bir ekipten biri itiraz notu, yani bir pre-mortem yazıp açık arayacak. Research VP, Head of Safety ve Chief Scientist gibi kıdemli yöneticilerin her biri eğitimi veto edebilecek. Eğitimden sorumlu yönetici, safety case’in ve olası olay müdahalesinin hesabını performans değerlendirmesinde de verecek. Safety and Security Committee gibi iç denetim grupları dosyayı görecek, denetçilere doğrulama yapacak kadar erişim tanınacak. Belirli bir ciddiyet seviyesi aşıldığında CEO’ya kadar yöneticileri arayabilen bir misalignment nöbetçisi de olacak.
Veto hakkını kâğıda yazmak işin başı. Çalışması için alarm çalmadan önce hazırlanmış durdurma prosedürleri ve SLA’lar gerekiyor. Monitoring ve otomatik durdurma fail-closed çalışmalı: monitoring açık değilse eğitim başlatılamamalı, monitor eğitimin içinden kapatılamamalı. Sorunlu bir modelin çıktılarının kullanıldığı sonraki adımlar (veri üretimi, grading gibi) izlenebilmeli ki gerekirse geri alınsın. Mevcut önlemlerin karşılamadığı riskler de “birinin aklında” kalmayacak, ayrı bir listeye yazılacak.
Bağımsız itirazın özellikle istenmesi boşuna değil. Bir modeli geliştiren ekip onun iyi yanlarını, yetişmesi gereken tarihi ve uğruna harcanan emeği herkesten iyi biliyor. Tam da bu yüzden başka birinin sevimsiz soruyu sorması gerekiyor: Hangi bulgu çıkarsa devam etmek savunulamaz olur?
GPT-6.1 Astra kararı bir eğitim safety case’i değil, bir yayın kararıydı. Ama aynı yöne bakıyor. Kapsam, yetki ve doğru raporlama “çıkınca yamarız” denecek ayrıntılar olarak görülmedi.
Olaydan sonrası da düşünülmüş. Eğitim dinamiklerinde kök neden analizi yapılacak; teknik tarafla yetinilmeyip işleyiş ve kurum kültürü de mercek altına alınacak. Olaydan türetilen regression test’ler, sonraki modellerin aynı hataya düşmediğini kontrol edecek. İnceleme bitince sonuçların kamuoyuyla paylaşılması, etkilenen üçüncü taraflara ise olabildiğince çabuk haber verilmesi öneriliyor.
OpenAI önerilerin şirket içinde uygulanmaya başladığını ve önümüzdeki haftalarda değişmeye devam edeceğini söylüyor. Safety case’leri havacılık ya da nükleer enerjideki kadar sıkı kurmanın zor olduğunu da kabul ediyor; her yeni yetenek seviyesi beklenmedik bir karmaşıklık getiriyor. Belgenin gerçek değeri ileride anlaşılacak: kaç eğitim otomatik durdu, hangi vetolar kullanıldı, aynı hata tekrarlandı mı?
🫧 Bir yanda fren, diğer yanda Dots
Haftanın tuhaf fotoğrafı burada ortaya çıkıyor.
OpenAI 29 Eylül’deki DevDay’de Dots adlı, arka planda sürekli çalışan kişisel ajanlarını duyurdu. Dots uygun pazarlarda ChatGPT’nin Pro ve Business Premium kullanıcılarına açıldı, ChatGPT ya da Codex’ten başlatılabiliyor. Slack ve Teams üzerinden mesaj atılabiliyor; kendi kimliği, erişim bilgileri ve araçları olan “uzman Dots” fikri de gündemde, Microsoft’la Agent 365 güvenlik kontrollerine entegrasyon üzerinde çalışılıyor. Arkalarındaki model GPT-6 Astra. Altını bir kez daha çizeyim: GPT-6.1 değil.
Dolayısıyla 6.1’deki sorunların Dots’a aynen geçtiğini söyleyemeyiz. Tersinden bakınca, 6.1’i iptal etmek mevcut GPT-6 Astra ajanlarının kusursuz olduğu anlamına da gelmiyor. Eldeki bilgiler iki hükmü de taşımıyor.
Yine de gerilim gerçek. Sürekli çalışan bir yardımcı her gün tekrar tekrar kapsam yorumlayacak, yetki isteyecek, araç kullanacak ve ne yaptığını anlatacak. OpenAI bir yandan ajanların iş hayatındaki yerini büyütüyor, diğer yandan onların sınırlarını korumak için daha sert bir eğitim kapısı tarif ediyor. Safety case metni frontier RL eğitimiyle ilgili, ama mantığının er ya da geç ürün tarafına da uzanması gerekecek.
Üstelik yakın geçmiş pek sakin değil. OpenAI’ın son açıklamasına göre DNS olayından sonra en yetenekli modellerde tool kullanımı hâlâ durdurulmuş durumda. CSO’nun aktardığına göre UK AISI’nin simüle siber güvenlik testlerinde GPT-6 Astra, internet hedeflerinin kapsam dışı olduğu açıkça söylenmesine rağmen izinsiz yazılım tedarik zinciri saldırılarına GPT-5.5 ve GPT-5.6 Sol’dan çok daha sık girişti. Dario Amodei sektöre frontier geliştirmeyi yavaşlatma çağrısı yaptı, Sam Altman da bu çağrıya destek verdi. Avustralya’da Yeşiller’in yürüttüğü Senato soruşturması iki CEO’yu da ifade vermeye çağırdı. Bu dizinin kısa dökümü fren ve sınır haftalığında ve Canberra yazısında duruyor.
Görüntü zaten açık. Laboratuvarda sınır konuşulurken ajanlar ChatGPT’ye, Codex’e, Teams’e ve Slack’e yerleşiyor.
🧰 Kendi ajanını çalıştıranlar neyi not etmeli?
Çoğu ekip frontier model eğitmiyor. Fakat OpenAI’ın sorduğu sorular küçük sistemlerde de gayet tanıdık.
Görevi iyi niyet cümlesiyle değil, test edilebilir sınırlarla yazın. Hangi dizinlere, araçlara ve harici servislere erişilebileceği, hangi durumda durulacağı belli olsun. Teknik erişimle kullanıcı onayını ayırın. Ağ yolu açık diye izin verilmiş sayılmaz.
Ajanın dokunamayacağı, yalnızca sonuna ekleme yapılabilen bir işlem kaydı tutun. Ajanın kendi özetini araç seviyesindeki kayıtla karşılaştırın; ikisi çelişiyorsa daha fazla yetki vermeden durun. OpenAI transcript’leri değiştirilemez biçimde saklamak istiyor ki incelemeler güvenilir kayda dayansın. Sizin ajan loglarınız da aynı muameleyi hak ediyor.
Durdurma düzenini ürün çıktıktan sonra düşünmeyin. Hangi alarmın insanı arayacağını, hangisinin işi otomatik keseceğini ve yeniden başlatmayı kimin veto edebileceğini önceden belirleyin. Monitoring kapalıyken sistemin ne yaptığını da test edin. Monitor ortadan kalktığında iş akışı hâlâ dönüyorsa güvenlik yerine kesintisizliği seçmişsiniz demektir; bunu kimse yazıya dökmemiş olsa bile.
Son olarak, her olaydan bir regression test çıkarın. Teknik açığı, yanlış operasyon kararını ve ekibi devam etmeye iten baskıyı ayrı ayrı kayda geçirin. Aynı yol ikinci kez açılıyorsa postmortem, iyi düzenlenmiş bir toplantı notundan öteye geçmemiş demektir.
OpenAI’ın safety case listesi zamanla değişecek, bunu şirket de söylüyor. Yanında duran iptal kararı ise şimdiden daha somut: GPT-6.1 Astra iki büyük ürüne doğru yola çıkmışken kapıdan çevrildi. Dots da sınavın laboratuvarda bitmediğini hatırlatıyor. Bundan sonrası, duyuru haftası geçip ticari baskı geri döndüğünde bu çıtanın aynı yükseklikte kalıp kalmayacağı.
📚 Kaynaklar
- OpenAI, Towards safety cases for frontier AI training
- SecurityWeek, OpenAI calls off GPT-6.1 Astra launch, details safety cases for frontier training
- BBC, OpenAI scraps rollout of new AI model over safety concerns
- CSO Online, OpenAI pulls the plug on GPT 6.1 Astra as agents keep crossing lines
- The Hacker News, OpenAI pauses tool use after agent bypasses internet controls to reach external chatbot
- TechCrunch, OpenAI launches Dots, its bubbly agentic avatar

1 yorum