Bir modelin “yüzde 95 eminim” demesiyle yazılımın kullanabileceği güven sinyali aynı şey değil. Jev confidence, Choice ve Score yanıtlarındaki probabilities dağılımını 0 ile 1 arasında bir değerde özetliyor; Noul yanıtında ise confidence bulunmuyor. Böylece uygulama kararı otomatik uygulayabiliyor, onay isteyebiliyor ya da işi durdurabiliyor.
TypeSafe dokümanlarını okurken bence asıl ayrım burada beliriyor. Kendinden emin bir cümle kulağa hoş gelir. Dağılım ise koda koşul olarak yazılır.
📐 Jev confidence nereden çıkıyor?
Serinin ilk gününde Jev’in üç temel çıktısına bakmıştık: Choice, Score ve Noul. Confidence bunlara eklenmiş dördüncü bir çıktı tipi değil. Choice ya da Score sonucundaki dağılımın biçiminden hesaplanan özet değer.
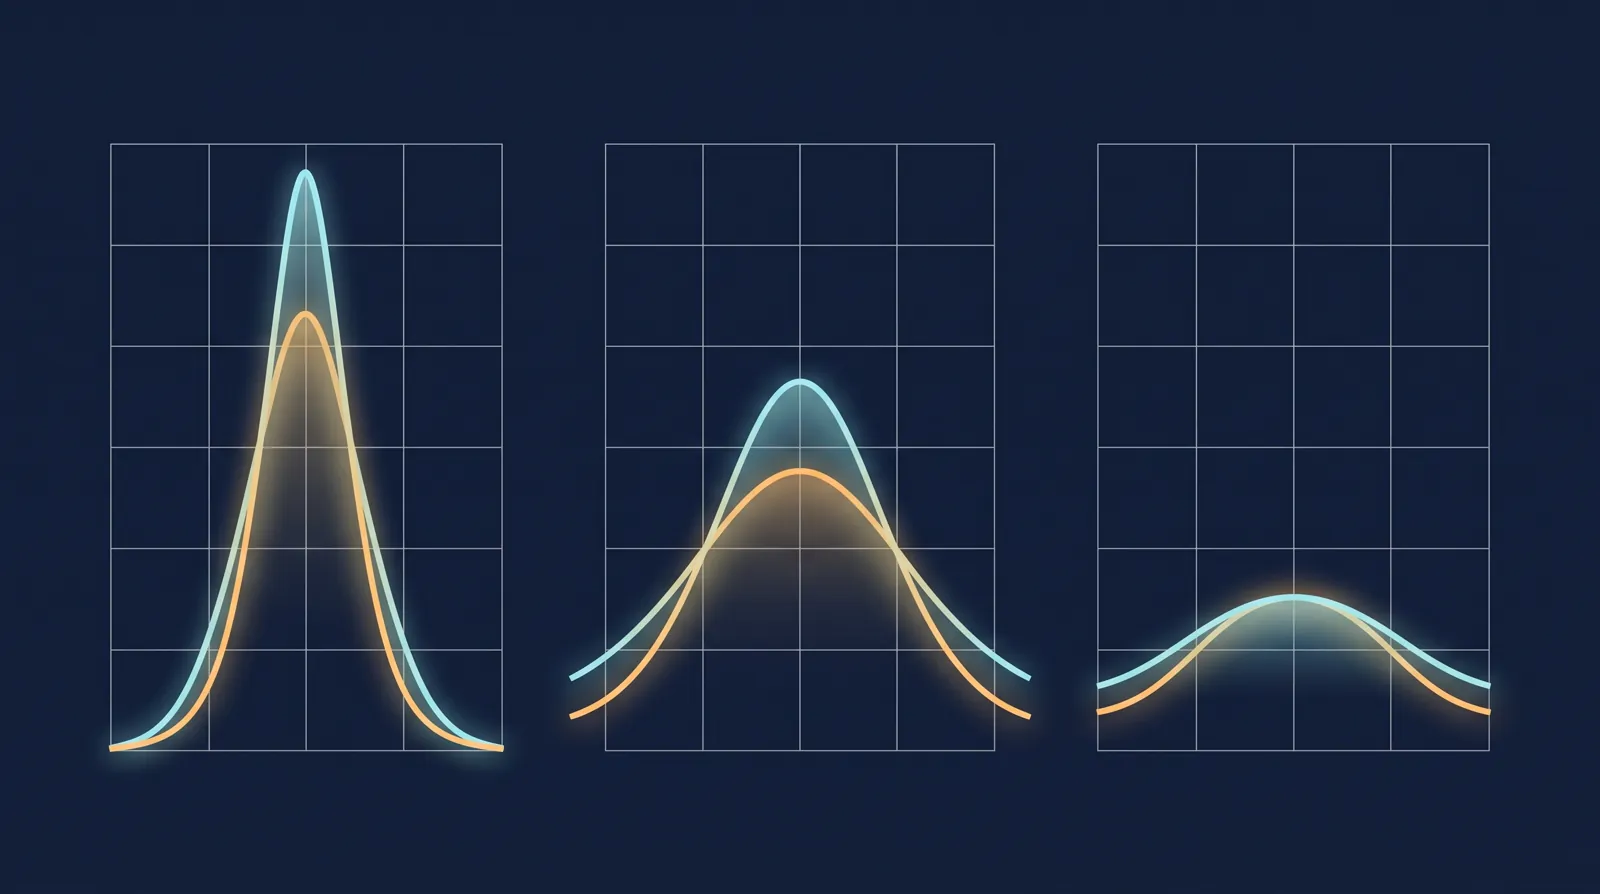
Üç seçenekli bir Choice düşünelim. Olasılık tek seçenekte yığılmışsa dağılım sivriliyor ve confidence yükseliyor. Değerler birbirine yakınsa dağılım düzleşiyor, confidence düşüyor. TypeSafe’in confidence dokümanında üç seçenek için şu örnek hesap yer alıyor:
(3 × en büyük olasılık − 1) / 2
Bu, örneği anlamaya yarayan yaklaşık formül. Gerçek confidence değerini Jev hesaplıyor. Üstelik yanıtta bütün probabilities dağılımı da duruyor. Yani ekipler TypeSafe’in tek sayılık özetine mahkûm değil; dağılımı inceleyip kendi karar kurallarını uygulayabilir.
Noul için aynı beklentiye girmemek gerekiyor. Noul, tip güvenli sayısal miktar döndürüyor ve confidence taşımıyor. Choice seçenekler, Score ise sıralı seviyeler arasında karar verdiği için bu dağılım ikisinde anlam kazanıyor.
Düşük confidence bu yüzden bozuk yanıt demek değil. Yazılımın anlayacağı türden bir “bilmiyorum” işareti. Sohbet modellerinde tereddütsüz yanıt marifet sayılabiliyor. Otomasyon tarafında bazen en değerli çıktı, durmayı bilmektir.
🎛️ Üç yol var, eşik riske göre değişiyor
Uygulama tarafındaki düzen hayli anlaşılır:
1. Confidence yüksekse otomatik hareket et. 2. Orta seviyedeyse temkinli ilerle, ek bilgi topla ya da onay iste. 3. Düşükse harekete geçme; soruyu netleştir, başka yönteme dön veya bir insana aktar.
Fakat her karar için aynı sayıyı kullanmak doğru değil. TypeSafe’in confidence-gated routing örneğinde sesli bankacılık uygulaması check_balance, approve_transfer ve support arasında Choice üretiyor. Confidence 0,6’nın altındaysa görüşme destek görevlisine aktarılıyor. Bakiye sorgusu 0,6 ve üstünde ilerleyebiliyor; para transferini otomatik onaylamak içinse 0,85’in üstü aranıyor. Arada kalan durumda kullanıcıdan onay isteniyor.
Bunlar bütün ürünler için geçerli sabitler değil, örnek eşikler. Kalıcı fikir şu: Hatanın bedeli yükseldikçe otomasyon eşiği de yükselmeli. Aynı Choice içinden çıksa bile bakiye okumakla para taşımak aynı risk değil.
Bir başka faydası daha var. Yanıt “ne seçildi?” sorusuna, confidence ise “buna göre hareket edelim mi?” sorusuna cevap veriyor. Son söz yine ürün kodunda. Üstelik sayısal eşik test edilebilir, kayda geçirilebilir. Prompt içine “transferlerde çok dikkatli ol” yazmaktan daha elle tutulur bir politika.
🧪 RLCD neden RLHF ve RLVR’dan farklı?
TypeSafe, kullandığı eğitim yöntemine Reinforcement Learning for Calibrated Decisions, kısa adıyla RLCD diyor. Confidence sonradan iliştirilmiş süs değilse, modelin eğitim hedefinde de kalibrasyon bulunmalı.
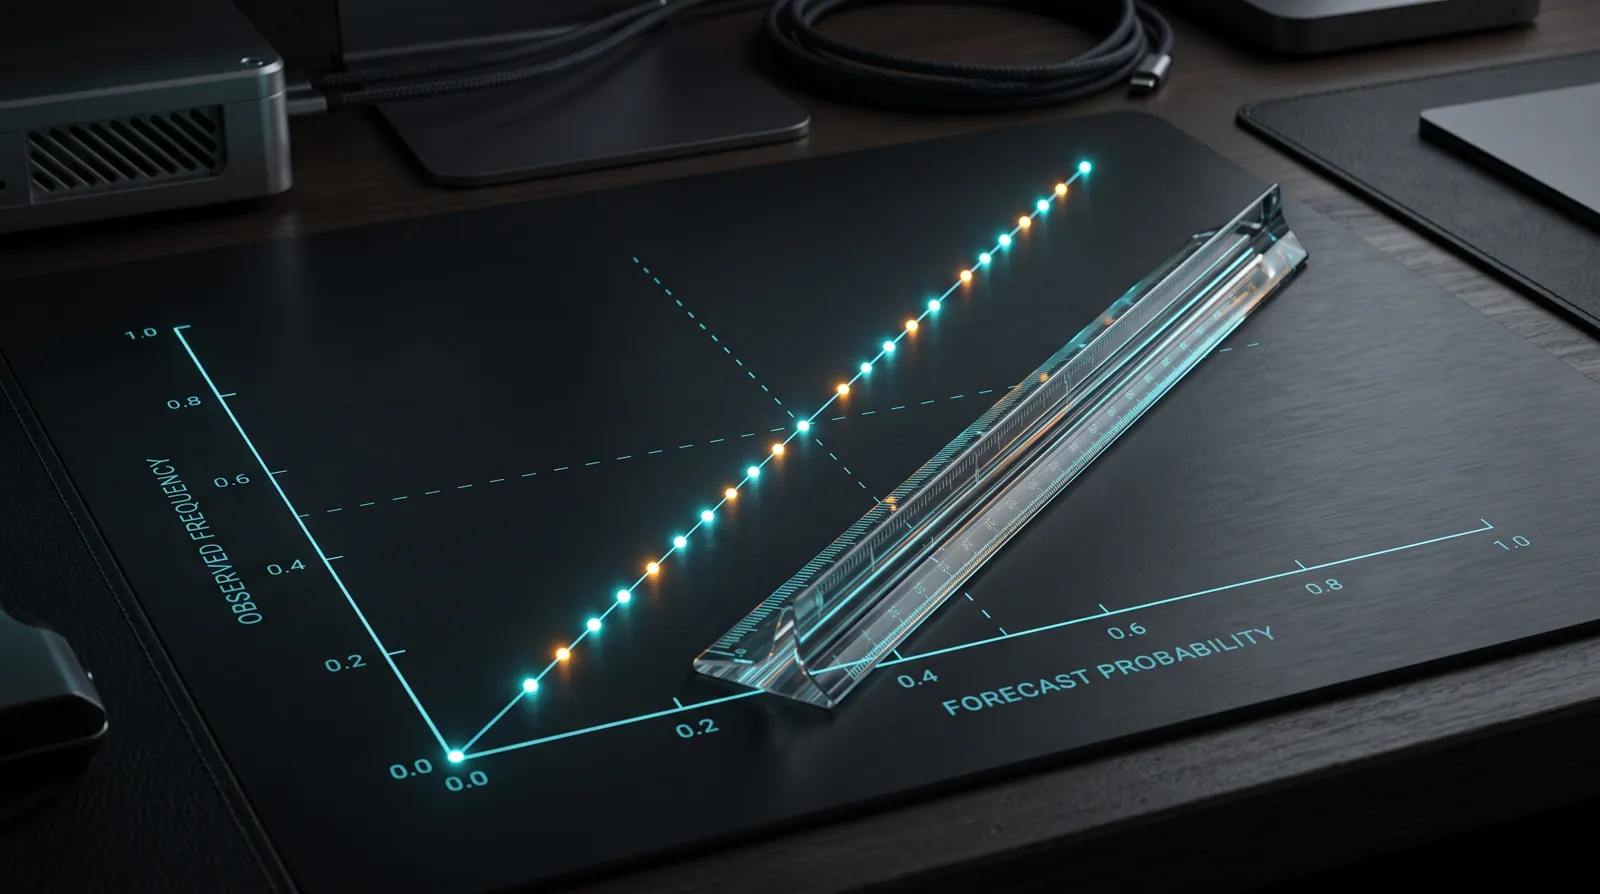
Şirketin machine-learning primer’ı kalibrasyonu tek yanıt üzerinden değil, sonuç grupları üzerinden anlatıyor. Olasılığı 0,2 verilen olayların yaklaşık yüzde 20’si; 0,8 verilenlerin yaklaşık yüzde 80’i; 1,0 verilenlerin de yaklaşık yüzde 100’ü gerçekleşmeli. Dolayısıyla 0,8, tek bir karar için başarı garantisi değil. Çok sayıda tahminle gerçek sonuç arasındaki ölçülebilir uyum.
RLHF insan tercihlerini, RLVR ise doğrulanabilir ödülleri optimize ediyor. TypeSafe’e göre RLHF; kullanıcıya yaranan yanıtlar, kendinden emin görünen halüsinasyonlar ve farklı çıktı ihtimallerinin azalması gibi sorunlar doğurabiliyor. İnsanların beğendiği cümle ile başında kimse olmadan çalışacak makinenin güvenilir kararı aynı hedef değil.
RLCD’nin hedefi kalibre kararlar. TypeSafe’in System One ve Jev duyurusundaki karşılaştırmaya göre LLM’ler string üretiyor ve confidence sorulduğunda tutarsız, fazlasıyla emin yanıtlar verebiliyor. Jev ise Choice ve Score için confidence ile probabilities içeren tip güvenli değer döndürüyor. Bunun arkasında yeni model mimarisi, parallel sampler ve RLCD var.
İddianın sınırını iyi çizmek lazım. “Model ne zaman haklı olduğunu bilir” gibi sihirli bir cümleden söz etmiyoruz. Kalibrasyon, confidence yükseldikçe tekrar eden vakalardaki doğruluğun da yükselmesi demek. Ölçülebilir, yeni veri dağılımında bozulabilir, kötü seçilmiş eşikle yanlış kullanılabilir. Şüphe artık makinenin okuyacağı biçimde. Mühendislik ihtiyacı ortadan kalkmış değil.
⚠️ jev-1.13 her soruda aynı beceriyi göstermiyor
İyi confidence için önce iyi tarif edilmiş bir karar gerekiyor. TypeSafe’in 17 Eylül 2026’da gözden geçirdiği jev-1.13 jaggedness dokümanı, modelin tökezlediği yerleri açıkça sıralıyor.
jev-1.13 gündelik System One muhakemesinde iyi. Araya fazladan dolaylılık girdiğinde, ifade fazla kelimesi kelimesine okuma gerektirdiğinde, matematik ve sayım işlerinde, tarih karşılaştırmalarında zorlanabiliyor. Gereksiz uzun state, saldırgan içerik ve ölçütlerle çelişen talimatlar da sonucu bozabiliyor. Aynı sorunun Noul ve Choice biçimlerinin kendi aralarında yapısal olarak tutarlı olacağına dair garanti yok.
Bazı işleri modele bırakmamak daha akıllıca:
- Sayma ve hesabı kodda yapın.
- Tarihi gerekiyorsa modelle çıkarın, karşılaştırmayı kodda tamamlayın.
stateiçindeki gereksiz bilgiyi önce süzün.- Bir sorunun içine birkaç ayrı hüküm saklamayın.
- Çok adımlı System Two işlerini ve metin üretimini Jev’e vermeyin.
Buradaki uyarı küçük puntolu kullanım şartı değil. Dağınık soruya yüksek confidence ile verilen yanıt, soruyu düzgün hale getirmiyor. Girdi, ölçüt ve karar sınırı yine bizim işimiz.
TypeSafe, Jev’i “frontier-intelligence function call” diye tarif ediyor: yapılandırılmamış durum giriyor, tip güvenli olasılıksal karar çıkıyor. String üretiminden vazgeçmek anlaşmanın bir parçası. Şemaya uyum garanti olsa da doğru şemayı ve doğru işi seçmek uygulamayı kurana kalıyor.
Kalibre şüphe işe yarayan bir ürün özelliği
Serinin ana yazısında System One karar modellerini açmış, ilk günde Jev’in döndürdüğü değerleri incelemiştik. Confidence ve RLCD, Choice ile Score’un “güven, doğrula ya da dur” kararına yetecek belirsizliği nasıl taşıdığını gösteriyor.
Sohbet cesaretinden daha faydalı olmasının sebebi de bu. Yazılıma tutunacağı bir kontrol noktası veriyor. Yarın hız ve maliyet tarafına bakacağız; kötü kurulmuş sorunun hızlı yanıtını başarı saymadan.
