Doom oynayan yeni bir AI modeli çıktı. Tabii Doom söz konusu olunca ayrıntılar küçük puntoda kalıyor.
TypeSafe AI'nin Jev adlı modeli ekrana bakmıyor. Piksel görmüyor. Oyundan gelen yapılandırılmış metin verisini okuyor, önündeki seçeneklerden birini seçiyor ve bunu saniyede yaklaşık on kez tekrarlıyor. Şirketin hesabına göre bu temponun saatlik bedeli 7 dolar civarında.
Gösterişli demoyu bir kenara koyunca geriye daha işe yarar bir fikir kalıyor: Yazılım her seferinde paragraf istemez. Bazen bir etiket, bir puan ya da evet olasılığı yeter.
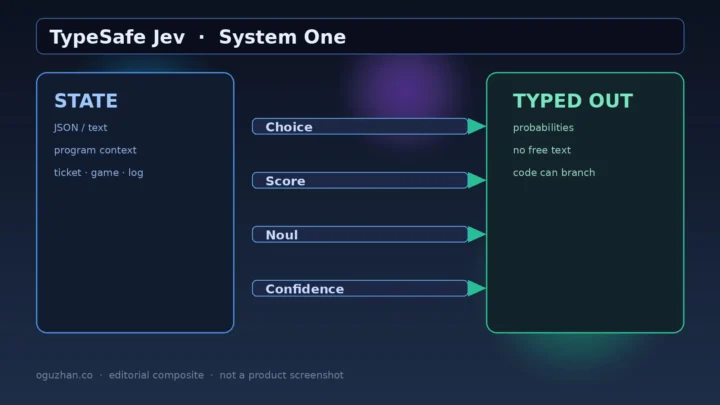
TypeSafe Jev tam olarak bunun için yapılmış. Bir state ve tipli sorular gönderiliyor; Choice, Score ya da Noul cevapları geliyor. Serbest metin yok. Sohbet yok. Kodunuz kararı alıyor, kendi kuralına göre uyguluyor.
Bu yazı, oguzhan.co'daki yedi günlük Jev serisine genel bakış. Önümüzdeki günlerde primitive'lerden güven hesabına, RLCD'den maliyete, ajan korumalarından bağlam sıkıştırmaya kadar her başlığı ayrı açacağım. Önce elimizdeki ürünü doğru yere oturtalım.
Bir modelden cümle istememek
TypeSafe AI, iki yıllık gizli çalışmanın ardından Eylül 2026'da Jev'i duyurdu. Kurucu Diogo Almeida'nın lansman yazısındaki temel itiraz tanıdık: AI çıktısını artık yalnız insanlar tüketmiyor. Yazılımlar da kullanıyor ama onlara hâlâ metin üreten modellerin cevabını parse ettiriyoruz.
Bir destek bileti düşünün. Kodun bilmek istediği şey “hangi birim?” sorusunun cevabı. Modelden uzun bir gerekçe alıp içinden billing sözcüğünü ayıklamak tuhaf bir dolambaç. Üstelik model listede olmayan bir birim de uydurabilir.
Jev'de istek iki parçadan oluşuyor:
1. İncelenecek metin, JSON nesnesi ya da metin dizisi state olarak gidiyor. 2. Her biri Choice, Score veya Noul tipinde olan sorular ekleniyor.
Choice, kapalı bir listeden seçim yapıyor. Sonuçta seçilen seçenek, tüm seçeneklerin olasılık dağılımı ve güven değeri var.
Score, sıralı bir rubrik üzerinde konum belirliyor. Hata şiddeti, müşteri öfkesi ya da risk seviyesi gibi işler için.
Noul, evet/hayır biçimindeki bir önermenin doğru olma olasılığını 0 ile 1 arasında veriyor. Ayrı bir confidence alanı yok.
Aynı state üstünde çalışan farklı tipteki sorular tek istekte buluşabiliyor. Jev bunları paralel değerlendiriyor. Son sözü model değil, uygulama söylüyor: yüksek güvende otomatik yönlendir, aradaki vakayı insana bırak, riskli olanı durdur.
System One adı nereden geliyor?
İsim, Daniel Kahneman'ın Thinking, Fast and Slow kitabındaki System 1 ve System 2 ayrımına gönderme yapıyor. System 1 hızlı yargıları; System 2 daha yavaş, zahmetli düşünmeyi anlatıyor.
TypeSafe bu ayrımı ürün sınırı olarak kullanmış. “Bu müşteri iade mi istiyor?” Jev'e uygun. “Müşterinin geçmişini incele, olası nedenleri araştır, en iyi çözümü planla ve kibar bir yanıt yaz” derseniz başka bir iş tarif ediyorsunuz.
Chat modelleri genel amaçlı string makineleri. Esneklikleri buradan geliyor. Plan yazıyor, kod üretiyor, gerekçe anlatıyorlar. Fakat bir ajan döngüsünde karar vermek için her seferinde token token metin üretmek hem süreyi hem faturayı büyütüyor.
Jev'in iddiası daha dar: Ürün bir kararsa, modeli karar vermek için eğit.
Şirket bu eğitim yaklaşımına RLCD, yani Reinforcement Learning for Calibrated Decisions adını veriyor. Amaç, kulağa hoş gelen metinden ziyade belirsizliği dürüstçe yansıtan olasılıklar üretmek. RLCD sisteminin tamamını bağımsız olarak yeniden kuran ve doğrulayan bir çalışma henüz görmedim. Şimdilik bunu şirketin eğitim yöntemi olarak kayda geçirmek daha doğru.
“Halüsinasyon yapmıyor” cümlesinin sınırı
Jev'in çıkışıyla en çok dolaşan iddia buydu. Küçük puntayı burada da okumak gerekiyor.
Choice için sales, billing ve support seçeneklerini verdiyseniz model dördüncü bir departman uyduramıyor. Noul sorusuna hikâyeyle cevap veremiyor. Çıktı, sizin tanımladığınız şemanın içinde kalıyor.
Yanlış billing seçeneğini işaretleyebilir.
The Register’ın lansman haberinde Thomas Claburn da aynı ayrımı yapıyor. Serbest metin üretmeyen bir sistem için “halüsinasyonsuz” demek, chat modeliyle yapılan karşılaştırmanın kategorisini değiştiriyor. Yapılandırılmış yanlış cevap, yanlış olmaktan çıkmıyor.
TypeSafe'in jev-1.13 jaggedness notları bu bakımdan şirket sitesinde görmeye alışık olmadığımız kadar açık. Sayma ve aritmetik zayıf olabiliyor. Tarih karşılaştırmaları kırılabiliyor. Büyük state içindeki ilgisiz ayrıntılar modeli şaşırtabiliyor. Talimatları fazla kelimesi kelimesine okuyabiliyor. Birbiriyle ilişkili sorular arasında beklediğiniz matematiksel tutarlılık da garanti değil.
Hesabı kodda yapın. Büyük metni önce süzün. Modelin puanını denetim raporu yerine koymayın.
Güven puanı kime güveniyor?
Choice ve Score cevaplarındaki güven değeri ikinci bir modelden gelmiyor. TypeSafe bunu olasılık dağılımından türetiyor. Dağılım tek seçenekte sivrildikçe güven yükseliyor; seçenekler birbirine yaklaştıkça düşüyor.
Bundan sonrası ürün sahibinin işi.
Destek biletini yanlış kuyruğa göndermek düzeltilebilir. Ödeme yapmak, veri silmek ya da dışarıya e-posta atmak başka bir risk sınıfı. Aynı 0,75 eşiğini bütün bu işlemlere uygulamak kalibrasyon sayılmaz.
Üretime almadan önce etiketli örneklerle false positive ve false negative oranlarına bakmak gerekiyor. Orta bölgede ne olacağı da baştan belli olmalı. İnsan incelemesi mi? İkinci bir deterministik kontrol mü? İşlemi reddetmek mi?
Jev karar veriyor. Politika hâlâ sizde.
Rakamlar güzel, dipnotları daha güzel
TypeSafe'in yayımladığı workflow değerlendirmelerinde Jev, hız ve maliyet grafiğinin Pareto cephesinde geniş bir alan tutuyor. Şirket materyalindeki tepe değerler, aynı harness içindeki LLM tabanlarına kıyasla yaklaşık 193,6 kat hız ve 444,6 kat düşük maliyet.
Bu rakamları tek satır paylaşmak kolay. Kurulumunu anlatmak biraz daha uzun.
Workflow'ları TypeSafe'in kendi yetenek ekibi hazırlamış. Referans olasılıklar için lansman yazısında GPT-6 Astra ile Fable 5.1 ortalaması kullanılıyor. LLM'ler de Jev ile aynı biçimde karar döndürebilsin diye System One uyumlu bir sarmalayıcıya alınmış. Bu yöntem, modellerden sıradan serbest metin istemeye göre daha yavaş ve pahalı olabilir.
Başka iki modelle aynı cevaba yaklaşmak, sahadaki gerçeği ölçmek değildir. Yine de paralel örnekleyicinin maliyet ve gecikme tarafında farklı bir yol açtığını gösteriyor. Kendi destek kuyruğunuzda, kendi dolandırıcılık verinizde ya da kendi ajan politikanızda yeniden koşmadığınız sürece grafik şirketin grafiği olarak kalır.
0,042 dolar ve 70-500 milisaniye
Lansman fiyatı milyon girdi token'ı için 0,042 dolar. Çıktı token'ı ücretsiz. TypeSafe uçtan uca gecikmeyi 70 ile 500 ms arasında veriyor. OpenRouter'daki typesafe/jev-1.13 kaydı da aynı fiyatı listeliyor.
Bağlam tarafında TypeSafe dokümanı toplam istek için 64k, state ile en uzun sorunun toplamı için 32k sınırından söz ediyor.
Bu fiyat kalıcı mı, sübvanse mi? Şirket de uzun vadeli sürdürülebilirliğin zamanla görüleceğini söylüyor. Ayrıca karşılaştırılan işler aynı değil. Uzun bir tool izi yazan frontier model ile birkaç tipli alanı paralel döndüren karar modeli doğal olarak farklı faturalar çıkarır.
Test yaparken sürümü sabitlemek şart. jev-1.13.0 belirli bir hedef; jev-latest ise yarın başka model olabilir. Sağlayıcı adları da değişiyor:
- OpenRouter:
typesafe/jev-1.13 - Vercel AI Gateway:
typesafe-ai/jev - Cloudflare Workers AI:
typesafe/jev
Vercel duyurusu, Jev'i AI SDK 7'nin deneysel evaluate API'siyle sunuyor. Buradaki Boolean tipi TypeSafe'in Noul primitive'ine denk. Cloudflare Workers AI ise Noul adını koruyor.
Modeli sabitleyip sağlayıcıyı yazmayan benchmark yarım nottur.
Doom, Wikiracing ve 255 seçenek
Doom demosunun neleri kanıtlamadığını başta gördük. Görü modeli yok. Ekran görüntüsü yok. Oyun motorundan gelen düzenli metin var. Asıl gösteri, değişen duruma karşı hızlı ve kısıtlı karar üretebilmek.
Wikiracing demosu başka bir sınıra dayanıyor. Bir Wikipedia sayfasında yüzlerce, bazen binlerce bağlantı bulunabiliyor. Jev'in Choice primitive'i en fazla 255 seçenek kabul ediyor. Daha kalabalık listelerde önce puanlayıp sonra seçen iki aşamalı bir yöntem kullanılıyor.
Serbest metin modeli yol boyunca var olmayan bir link uydurabilir. Choice ise önüne konan gerçek bağlantılardan birini seçmek zorunda. Çok adımlı gezintide bu kısıt işe yarıyor.
Bunlar genel zekâ ispatı değil. Biri düşük gecikmeli tepkisel kararı, diğeri kalabalık aday listesindeki kısıtlı seçimi gösteriyor. Bir demo için gayet yeterli.
Topluluk yüz projeyi geçti
cobanov/awesome-jev, şu an Jev çevresindeki en derli toplu harita. 19 Eylül araştırma notlarında topluluk projelerinin sayısı 100'ü aşmıştı. Hızlı davranmışlar.
Listede birkaç belirgin damar var:
jev-guard, ajanların tool çağrılarını allow, ask ve deny olarak puanlıyor.is-malicious, kaynak ve CI dosyalarını çalıştırmadan önce inceliyor.- Canny, kod ajanlarının kanıtsız “bitti” iddiasına itiraz ediyor.
fast-jev-compactionbenzeri araçlar, uzun ajan bağlamında nelerin tutulacağını sıralıyor.- Resmi JavaScript ve Python SDK'larının yanında Ruby, Zod, Python ve CLI istemcileri yer alıyor.
- LitJev, openjev, kev ve NanoJev açık modellerde benzer karar başlarını deniyor.
Son grubu TypeSafe'in özel RLCD sisteminin kopyası diye sunmamak gerek. Bunlar aynı fikrin çevresindeki bağımsız denemeler.
Nerede kullanılır, nerede kapıdan çevrilir?
Karar dar, seçenekler belli ve gecikme önemliyse Jev'e bakılır. Niyet yönlendirme, triyaj, rubrik skorlama, moderasyon kapısı, atıf kontrolü, ajan içinde tool seçimi ve büyük veri kümelerini etiketleme buna uyuyor.
Yazı yazdırmak, açık uçlu plan kurmak, yaratıcı üretim yapmak ya da birkaç aşamalı muhakemeyi tek soruya doldurmak için uygun değil. Hesap makinesi de değil. Geçerli Choice cevabı denetim mührü hiç değil.
Benim aklımdaki en temiz kurulum şöyle:
1. Eldeki olayı ya da nesneyi state haline getir. 2. İhtiyaç duyulan dar soruları aynı çağrıda sor. 3. Eşikleri uygulama kodunda uygula. 4. Belirsiz vakaya kaçış yolu bırak. 5. Sonuçları gerçek trafik üstünde ölç.
Jev'i “ucuz GPT” diye okumak fikri küçültüyor. Bu, kodun çevresini çizdiği bir karar katmanı. Yetkisi de sınırı da programda kalıyor.
oguzhan.co Jev dosyası
Bu genel bakış yazısının ardından seri 20-26 Eylül 2026 arasında yayımlandı. Bölümlerin hepsi yayında:
- Primitive'ler: Noul ne demek, Choice, Score ve
state + questionsAPI'si - Güven ve RLCD: olasılıklar, eşikler ve jaggedness
- Hız ve maliyet: paralel örnekleyici, fiyat ve 70-500 ms iddiası
- Ajanlar ve guardrail: jev-guard, Canny, is-malicious ve geri dönüş yolları
- Bağlam sıkıştırma: model neyi seçebilir, kod neyi korumalı?
- Gerçek zamanlı demolar: Doom, Wikiracing ve metin
stateayrıntısı - Ekosistem ve sınırlar: sağlayıcılar, açık denemeler ve Jev'e bırakılmayacak işler
Tek bir yazı okuyacaksanız primitive'lerle başlayın. En küçük parçayı, yani tek bir soruyu doğru tipe yerleştirmeyi orada anlattım.
Sitedeki bütün Jev yazıları, önerilen okuma sırasıyla birlikte Jev dosyası sayfasında.
Kaynaklar
İlgili: önce Jev primitive’leri: Choice, Score ve Noul, sonra kalibre yönlendirme için Jev confidence ve RLCD.
- TypeSafe AI: Introducing System One Models and Jev
- TypeSafe dokümantasyonu: Primitives
- TypeSafe dokümantasyonu: Jev 1.13 jaggedness
- cobanov/awesome-jev
- The Register: TypeSafe AI debuts model for machines that plays Doom
- Vercel: TypeSafe AI’s Jev on AI Gateway
- OpenRouter: typesafe/jev-1.13
- Cloudflare Workers AI: Jev

6 yorum