OpenAI tam olarak ne yayımladı?
OpenAI matematik sonuçları, henüz kullanıma açılmamış şirket içi bir modelin ürettiği 722 makaleden oluşuyor. Depoda 372 sonuç ailesi var. Bunların önemli bir bölümüne Lean formalizasyonu eşlik ediyor ancak tamamı formalize edilmiş ya da hakem denetiminden geçmiş değil. Bağımsız AGMAI danışma grubunun yayımlama kuralları da ancak kısmen karşılanmış durumda.
Duyuru ABD Doğu saatiyle 6 Ekim akşamı 18:00’de, Türkiye’de 7 Ekim saat 01:00’de geldi. OpenAI’ın açıklamasında “geniş bir yeni matematiksel sonuç yelpazesinden” söz ediliyor. Şirket, Institute for Advanced Study bünyesindeki Advisory Group on Mathematics and Artificial Intelligence’a danıştığını ve grubun kamuya açık tavsiyelerinden yararlandığını söylüyor.
AGMAI ise 6 Ekim açıklamasında frene basıyor. Yayımlananları matematik açısından önemli bir olay sayıyor fakat danışmanlık rolünün sonuçların etkisine verilmiş bir hüküm ya da sürecin onayı gibi okunmamasını istiyor. İnsanların anlama süreci bitmedi, yeni başladı. Yerinde bir uyarı.
Deponun içinde ne var?
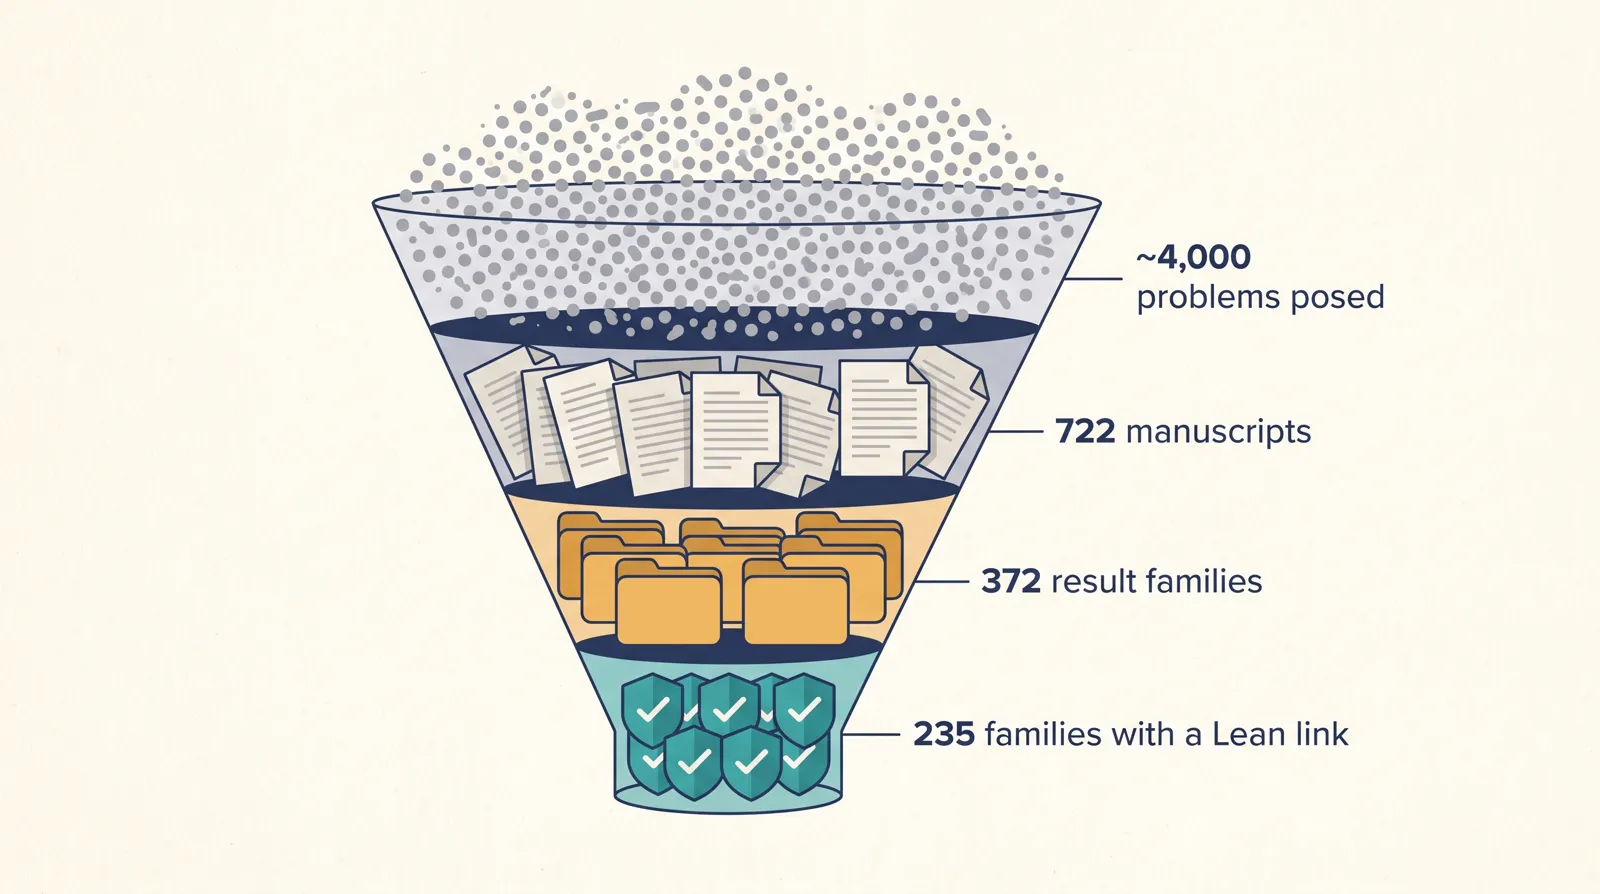
GitHub deposundaki README, bir sonuç ailesini ana bulgu ile ona eşlik eden argümanlar, çıkarımlar ve alternatif ispatların oluşturduğu küme olarak tanımlıyor. OpenAI, mevcut matematik eval’lerinde performans doygunluğa ulaştığı için değerlendirmeyi genişletmiş. Modele yaklaşık 4.000 problem verilmiş. Çıktılar bir araya getirilip yeterli önem eşiği uygulandığında geriye 372 aile ve 722 makale kalmış.
7 Ekim’de CONTENTS.md ve formalization.yaml dosyalarında yaptığım sayıma göre 372 ailenin 235’inde Lean bağlantısı var. Yaklaşık yüzde 63. Formalizasyon kataloğu ise “ana sonucu formalize edilmiş” 162 makale ve 185 Comparator challenge kaydı listeliyor. Birimlerin farklı olduğuna dikkat. Bu sayılardan herhangi birini doğrudan “doğrulanmış keşif sayısı” diye sunmak hatalı olur.
Kataloğun dili açık sözlü. Kapsam “Partial progress”, inceleme durumu “unchecked”, otomasyon yöntemi “agent” olarak işaretlenmiş. Lean dosyaları mathlib4, PrimeNumberTheoremAnd ve başka topluluk kütüphanelerine dayanıyor. Lean projesinin Comparator aracı da challenge ifadesi ile ispatı karşılaştırıyor.
Dosya yollarındaki tarihler 23-25 Eylül ile 4-5 Ekim’de kümeleniyor. On ayrı reasoning özeti bulunuyor. Bunlar 007, 017, 087, 102, 159, 197, 221, 271, 287 ve 362 numaralı ailelere ait. OpenAI, ortalama bir sonuç için yaklaşık üç saatlik ChatGPT Pro düşünme süresine denk compute kullanıldığını belirtiyor. Tek tek teoremlerin üretim öyküsü için ortalama hayli sınırlı bir bilgi.
Sabit prosedürün iki istisnası var. Riemann zeta fonksiyonunun sıfırsız bölgesi çalışması ile CM abelyen varyeteler için Hodge iddiası aynı yöntemi izlememiş. Re(s) > 11/12 yazısı da okunabilirlik için insan eliyle düzenlenmiş. Düzeltmeler yeni sürüm olarak kaydedilecek, eskileri erişilebilir kalacak ve her makalenin BibTeX kaydı olacak. Yayın düzeni açısından doğru işler bunlar.
OpenAI matematik sonuçları Lean ile nasıl okunmalı?
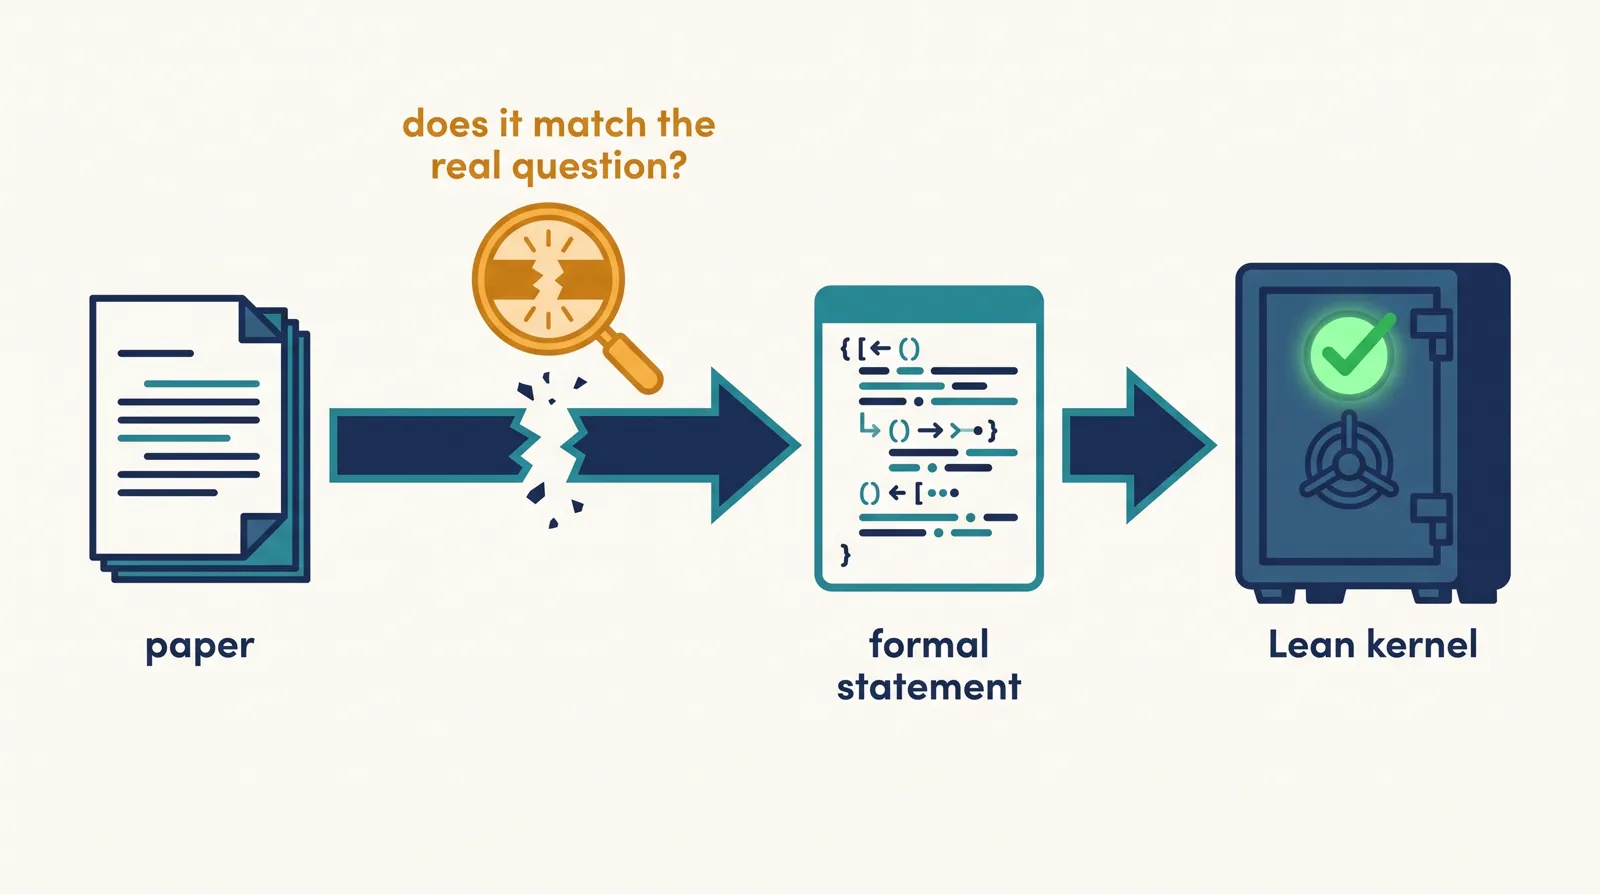
Lean’ın verdiği güvence kuvvetli ve sınırı belli. Belirtilen kütüphaneler ile güvenilen kernel içinde, formal bir ifadenin formal ispatının kontrol edildiğini gösteriyor. Bağımsız biri dosyaları temiz bir ortamda yeniden derlediğinde aynı makine dili içindeki çıkarımı ciddi ölçüde sınamış oluyor.
Fakat kernel’den önce gelen bir insan sorusu var: Formal ifade, matematikçilerin sorduğu problemi eksiksiz karşılıyor mu? Lean sessizce daraltılmış bir varsayımı kendi başına teşhis edemez. Teoremin ne kadar önemli olduğuna ya da açıklamanın insanlara yeni bir fikir verip vermediğine de karar veremez. Benim sayıma göre Lean bağlantısı bulunmayan 137 aile için zaten böyle bir kontrolden söz edemiyoruz.
Eylül ayındaki Navier-Stokes tartışması bu ayrımı iyi gösterdi. OpenAI’ın 8 Eylül duyurusu, başlangıçta hareketsiz ve pürüzsüz bir akışkanın, pürüzsüz bir dış kuvvet altında sonlu zamanda tekillik üretmesi hakkındaydı. Şirket Clay’in C ve D ifadelerini çözdüğünü savundu, Millennium Prize iddiasında bulunmadığını açıkça yazdı. Çalışmada yaklaşık 10.000 agent 88 saat boyunca kullanılmıştı.
Dış kuvvetli denklem ile kuvvetsiz denklem aynı soru değil. 22 Eylül tarihli yazımızda dış kuvvetli ve kuvvetsiz Navier-Stokes ayrımını incelemiştik. Dış kuvvetli sürüm için kusursuz bir formal ispat, meşhur dış kuvvetsiz problemi çözmez. Yeni depodaki 376 numaralı aile de zaten “Universal computation in forced Navier-Stokes flows” (dış kuvvetli akışlarda evrensel hesaplama) başlığını taşıyor ve Turing makinesi derleyicisini dış kuvvete yerleştiriyor.
Scientific American, Lean ile doğrulanan sonuçları neredeyse kesin doğru diye tarif ediyor. Cümlenin sonuna şu kaydı eklemek gerekiyor: formal ifadeye göre doğru. Dört kelimelik fark, burada işin yarısı.
AGMAI kurallarına göre durum
OpenAI bazı matematikçilere dış danışma kurulu fikriyle gittikten sonra AGMAI bağımsız bir yapı olarak kuruldu. Ücretsiz çalışan dokuz üyesi François Charles, Camillo De Lellis, Timothy Gowers, Martin Hairer, Nikhil Srivastava, Ulrike Tillmann, Ravi Vakil, Edward Witten ve Melanie Matchett Wood. 29 Eylül kuralları 600’den fazla anket yanıtından beslendi. Grup, şirketlerin ileri matematik problemlerini kapalı modellerle test etmeyi bırakmasını ve matematik yayınlarını model pazarlama aracına çevirmemesini istiyor.
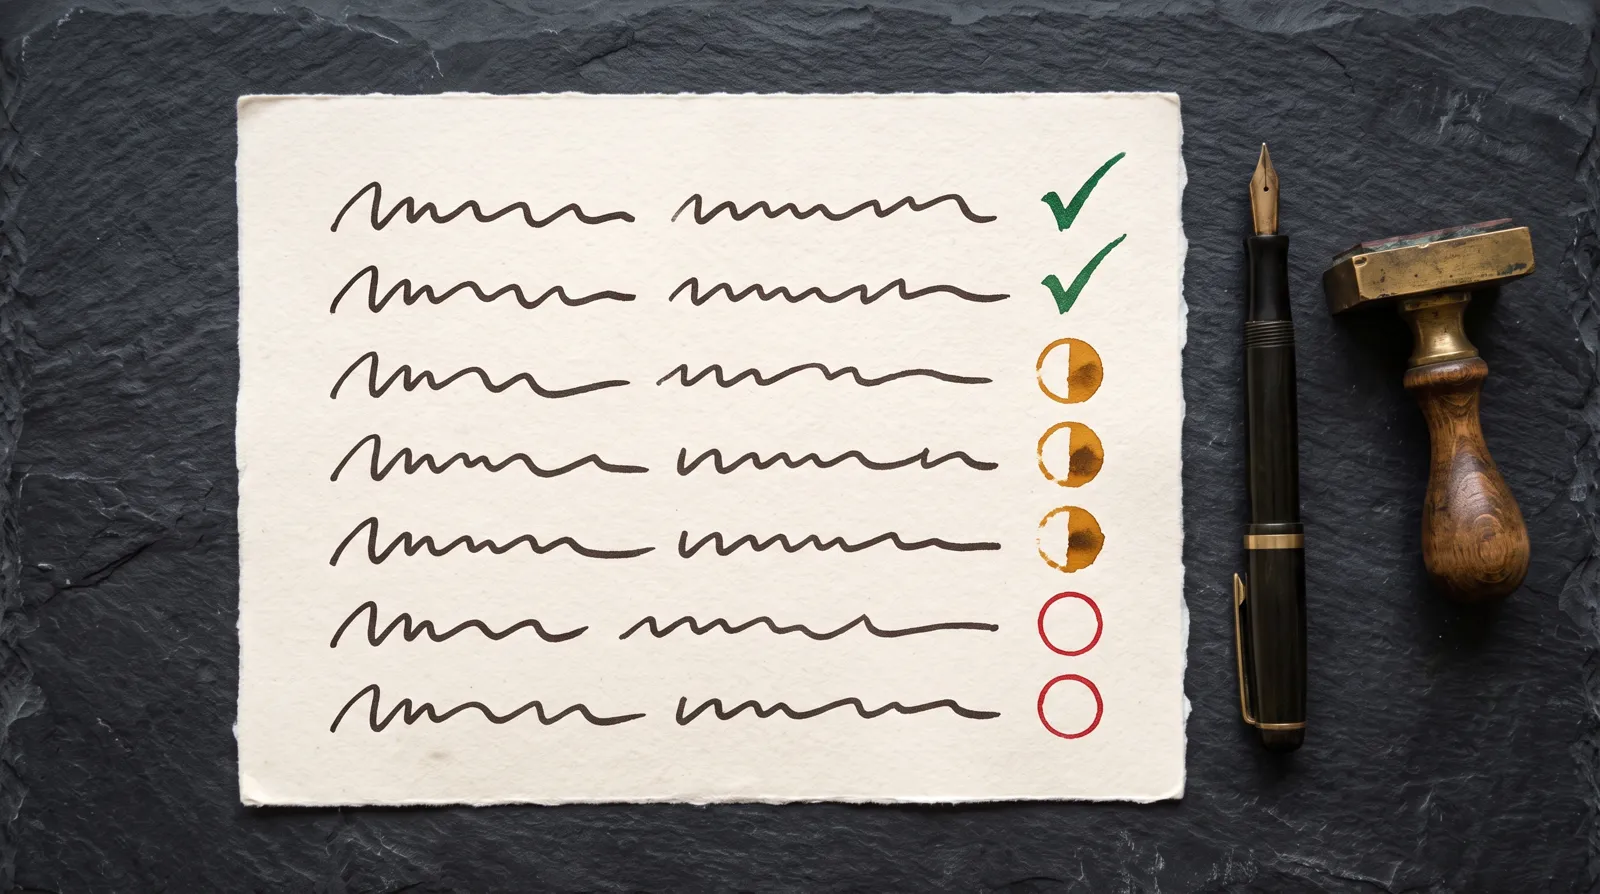
- Kural 1(a) ve 1(b), literatür taraması ve geleneksel makale düzeni: Depoda makaleler, atıflar ve sürüm sistemi var. OpenAI yine de gelecek yayınlarda atıfları, anlatımı ve sunumu iyileştireceğini söylüyor. Scientific American’a göre yeni sonuçların birçoğunu şirketin kendi matematikçileri de henüz anlamış değil. Hüküm: Kısmen karşılandı.
- Kural 2, bağımsız akademik depo: Dosyalar OpenAI’ın kontrolündeki GitHub organizasyonunda. Sürüm geçmişi ve BibTeX olumlu. Şirket topluluk tarafından barındırılan seçenekleri araştırdığını belirtiyor. Kalıcı akademik kimlik ve bağımsız ev sahibi henüz yok. Hüküm: Henüz karşılanmadı.
- Kural 3, her sonuç için üretim dökümü: Model adı, prompt, özetlenmiş düşünme zinciri, süre ve tahmini compute maliyeti isteniyor. Modelin adı ve erişimi yok. Prompt’lar yayımlanmadı. 372 aile için yalnızca 10 reasoning özeti ile genel ortalama verildi. Şirket sözcüsü de OpenAI’ın tavsiyelerle bağlı olmadığını söyledi. Hüküm: Karşılanmadı.
- Kural 4, mümkün olduğunca formalizasyon: Comparator challenge dosyaları ve
formalization.yamlmevcut. Durum etiketleri eksik ve incelenmemiş kısımları saklamıyor. AGMAI’ın istediği copyright başlıklarını ise açtığım Lean dosyalarında göremedim. Ailelerin yaklaşık yüzde 63’ünde Lean bağlantısı var. Hüküm: Bir alt küme için büyük ölçüde karşılandı. - Kural 5, problem seçimi ve başarısız denemeler: Yaklaşık 4.000 problem verildiğini biliyoruz. Eski eval’lerin doygunluğa ulaşması nedeniyle kapsamın genişletildiği de yazıyor. Benzer zorluktaki başarısız denemelerin ve problem seçiminin ayrıntılı dökümü yok. Hüküm: Kısmen karşılandı.
- İkinci aşama, insan anlayışını mevcut sivil kurumlar üzerinden fonlama: OpenAI atölye, konferans ve özel program desteği vaat ediyor. Karar mekanizması daha açıklanmadı. Hüküm: Vaat var, değerlendirme için erken.
- Geniş ve eşit erişim: AGMAI kapalı modellerin iki katmanlı bir düzen yaratmasından kaygılı. Model hâlâ şirket içinde. OpenAI sorumlu biçimde yayımlamak için çalıştığını söylüyor. Hüküm: Karşılanmadı.
Pazarlama maddesine gelince, okura tek bir veri bırakayım: Sam Altman X’te “We are entering a new era of discovery now” diye yazdı. Gerisini okur tartsın.
Laboratuvar kendi ürününe not verdiğinde değerlendirme sorunu büyüyor. Türkiye’de bağımsız AI değerlendirmesi üzerine yazımızda aynı sorunun kurumsal tarafına bakmıştık. AGMAI en azından herkesin kullanabileceği somut bir kontrol listesi sundu.
Büyük başlıkların küçük yazıları
102 numaralı aile, Khot’un Unique Games Conjecture’ını 3SAT’ten değer aralığı bulunan unique games problemine deterministik, polinom zamanlı indirgeme yoluyla ispatladığını öne sürüyor. Buna Goemans-Williamson sınırının ötesinde optimal Max-Cut zorluğu ve Vertex Cover’ı 2’den iyi oranla yaklaşık çözmenin zorluğu da eklenmiş. Lean notunda formal ifadeye P ≠ NP varsayımının yerleştirilmediği özellikle yazıyor.
107 numaralı aile kare matris çarpımı için karmaşık sayılar üzerinde ω(ℂ) ≤ 9/4, yani 2,25 sınırını veriyor. Her cisim için de ω(F) < 2.371054886006746 sonucu var. Lean dokümanı bunun aritmetik karmaşıklıkla ilgili olduğunu, bit karmaşıklığına veya pratik geçiş boyutlarına dair iddia taşımadığını söylüyor. Ekran kartınız bu sabah hızlanmadı.
003 numaralı aile, Riemann zeta fonksiyonu ile bütün Dirichlet L-fonksiyonları için Re(s) > 7/8 sıfırsız yarı düzlemi veriyor. Sonuç, Q(√-3) üzerindeki sonlu mertebeli Hecke L-fonksiyonlarını da içeriyor. Bir eşlikçi makale Re(s) > 11/12 sınırını ve açık sabit vermeyen düzgün bir Landau-Siegel dışlamasını sunuyor. Riemann hipotezinin istediği çizgi ise Re(s) = 1/2. Bazı Reddit başlıklarındaki "Riemann hipotezinin eksik ispatı" tanımı doğru değil.
074 numaralı aile üç boyutta Kakeya maksimal varsayımını ve dört boyutta Kakeya varsayımının Hausdorff boyutu sürümünü ele alıyor. 032, bütün karmaşık CM abelyen varyeteler için rasyonel Hodge varsayımını iddia ediyor. 376 ise dış kuvvet üzerinden Turing makinesi hesabını Navier-Stokes akışına taşıyor. Her birinin matematiksel yükü ve istisnası farklı. "Yüzlerce açık problem çözüldü" başlığı bu farkları siliyor.
Tedirginlik de yeni sayılmaz. 13 Eylül gündemimizde 25 Fields Madalyası sahibinin imzaladığı "A Severe Misalignment of AI in Mathematics" metnine yer vermiştik.
Tepkiler aynı yöne bakmıyor
Scientific American'a konuşan MIT'den Andrew Sutherland'ın ölçüsü net: Model açılıp başkaları sonuçları tekrarlayana kadar tek agent'ın tek seferde problem çözdüğü iddiaları doğrulanmış sayılmamalı. University of Toronto'dan Daniel Litt ise matematikçiler bu soruların yanıtını istiyorsa şirketten gizli tutmasını istemenin anlamı olmadığını, yayının matematiğe yarar sağlayacağını düşünüyor.
Terence Tao daha önce frontier laboratuvarlarından gelen sonuçların "çılgın" hızını eleştirmişti. 6 Ekim'de Mastodon'da, çözülmüş bir problemin yeniden çözümsüz hale getirilemeyeceğini ve çözümün varlığını bilmenin sonraki insan ve AI denemelerini değiştirdiğini yazdı. "Math 2.0" ham problem çözmenin ağırlığını azaltıp matematiksel ilerlemeyi daha geniş değerlendirmeli, diyor.
Steven Strogatz matris çarpımı üssündeki yaklaşık 2,37'den 2,25'e sıçramayı Bob Beamon'ın uzun atlayışına benzetti. Joe Bebel, bir buçuk yıldır çalıştığı Unique Games Conjecture için ispat ve Lean formalizasyonu iddiasıyla karşılaştığını yazdı. Jared Duker Lichtman çıktıyı "her nesnel ölçüte göre tarihi" diye niteledi, ardından haftalardır dolaşan Millennium problemi söylentisinin bu olmadığını ekledi. Heyecan yüksek. Kontrol listesi de uzun.
Bundan sonra neye bakmalı?
İlk adım modelin yayımlanması ya da bağımsız tekrara izin verecek kadar geniş erişim sağlanması. Her sonuç için tam prompt, deneme sayısı, süre ve compute dökümü de gerekli. Makaleler kalıcı kimlikleri olan, topluluğun yönettiği bir depoya taşınırsa sürüm takibi OpenAI'ın hesabına bağlı kalmaz.
Bağımsız ekiplerin Lean dosyalarını temiz ortamlarda yeniden derlemesi, formal ifadeleri özgün problemlerle tek tek karşılaştırması gerekiyor. Formalizasyonu bulunmayan ailelerde ise klasik hakem raporunun yerini dolduracak kısa yol yok. Uzmanların sonucu anlaması, anlatımı sınaması ve önceki literatürle bağını kurması zaman alacak.
OpenAI'ın fon vaat ettiği atölye, konferans ve özel programların kararlarını AGMAI'ın istediği gibi mevcut sivil kurumlar verirse süreç daha inandırıcı hale gelir. Şimdilik mekanizma açıklanmadı.
Ortada incelenebilir 722 metin var. Nasıl üretildiklerini doğrulayacak ayrıntılar eksik, formal kontrol de kataloğun bir bölümünü kapsıyor. Bu yüzden en makul okuma aile aile, teorem teorem ilerlemek. Matematiğin hızını duyuru saati belirlemiyor.
